La Mia Sala Server Domestica: Dal Raspberry Pi al Machine Learning
7 Gen. 2026
Alla fine del 2021 ho messo in piedi il mio primo server: il Raspberry Pi 4 che avevo comprato al liceo. Non immaginavo che quella schedina da pochi watt avrebbe dato il via a una piccola sala server di casa. Oggi gestisco cinque macchine, per sviluppo, hosting e soprattutto intelligenza artificiale.
Il Raspberry Pi: le basi
Era debole, ma bastava a far girare un server HTTP e a imparare l'amministrazione di sistema. Mi ha insegnato a gestire Linux, a configurare Apache, a litigare con i firewall e con il port forwarding del router. Era lento, si piantava spesso, e ogni errore era ore di debug. Ma funzionava, ed era mio.
Il ThinkCentre: la produzione
Dopo qualche mese il Pi non bastava più. Ho trovato un ThinkCentre usato con un Intel i5-6400T, 16 GB di RAM e un SSD da 2 TB. Non un mostro, ma per me un salto enorme.
Quella macchina è il cuore dell'infrastruttura, ed è ancora oggi quella che regge tutto il backend di questo sito: il CMS in Laravel, il tracker delle visite e PostgreSQL, tutto in Docker, con Caddy davanti al pannello di amministrazione. È la macchina più affidabile che ho: accesa 24 ore su 24 da oltre due anni senza un problema hardware. È lì che ho imparato a scrivere codice che deve stare in piedi in produzione, dove ogni downtime è una lezione.
L'HP ProLiant da 300 euro
Un giorno, scorrendo eBay, ho trovato un venditore che liquidava server enterprise. Tra questi un HP ProLiant DL380 Gen9 con due Xeon E5-2690 v3 e 256 GB di RAM. Prezzo: 300 euro. Non ci ho pensato due volte: 24 core e un quarto di terabyte di RAM aprono possibilità prima impensabili.
Al momento il server è spento, in attesa che trovi una GPU usata per il machine learning a un prezzo ragionevole. Con il boom dell'AI il mercato delle schede è impazzito, e sto aspettando che la bolla si sgonfi per completarlo.
Il NAS fai-da-te
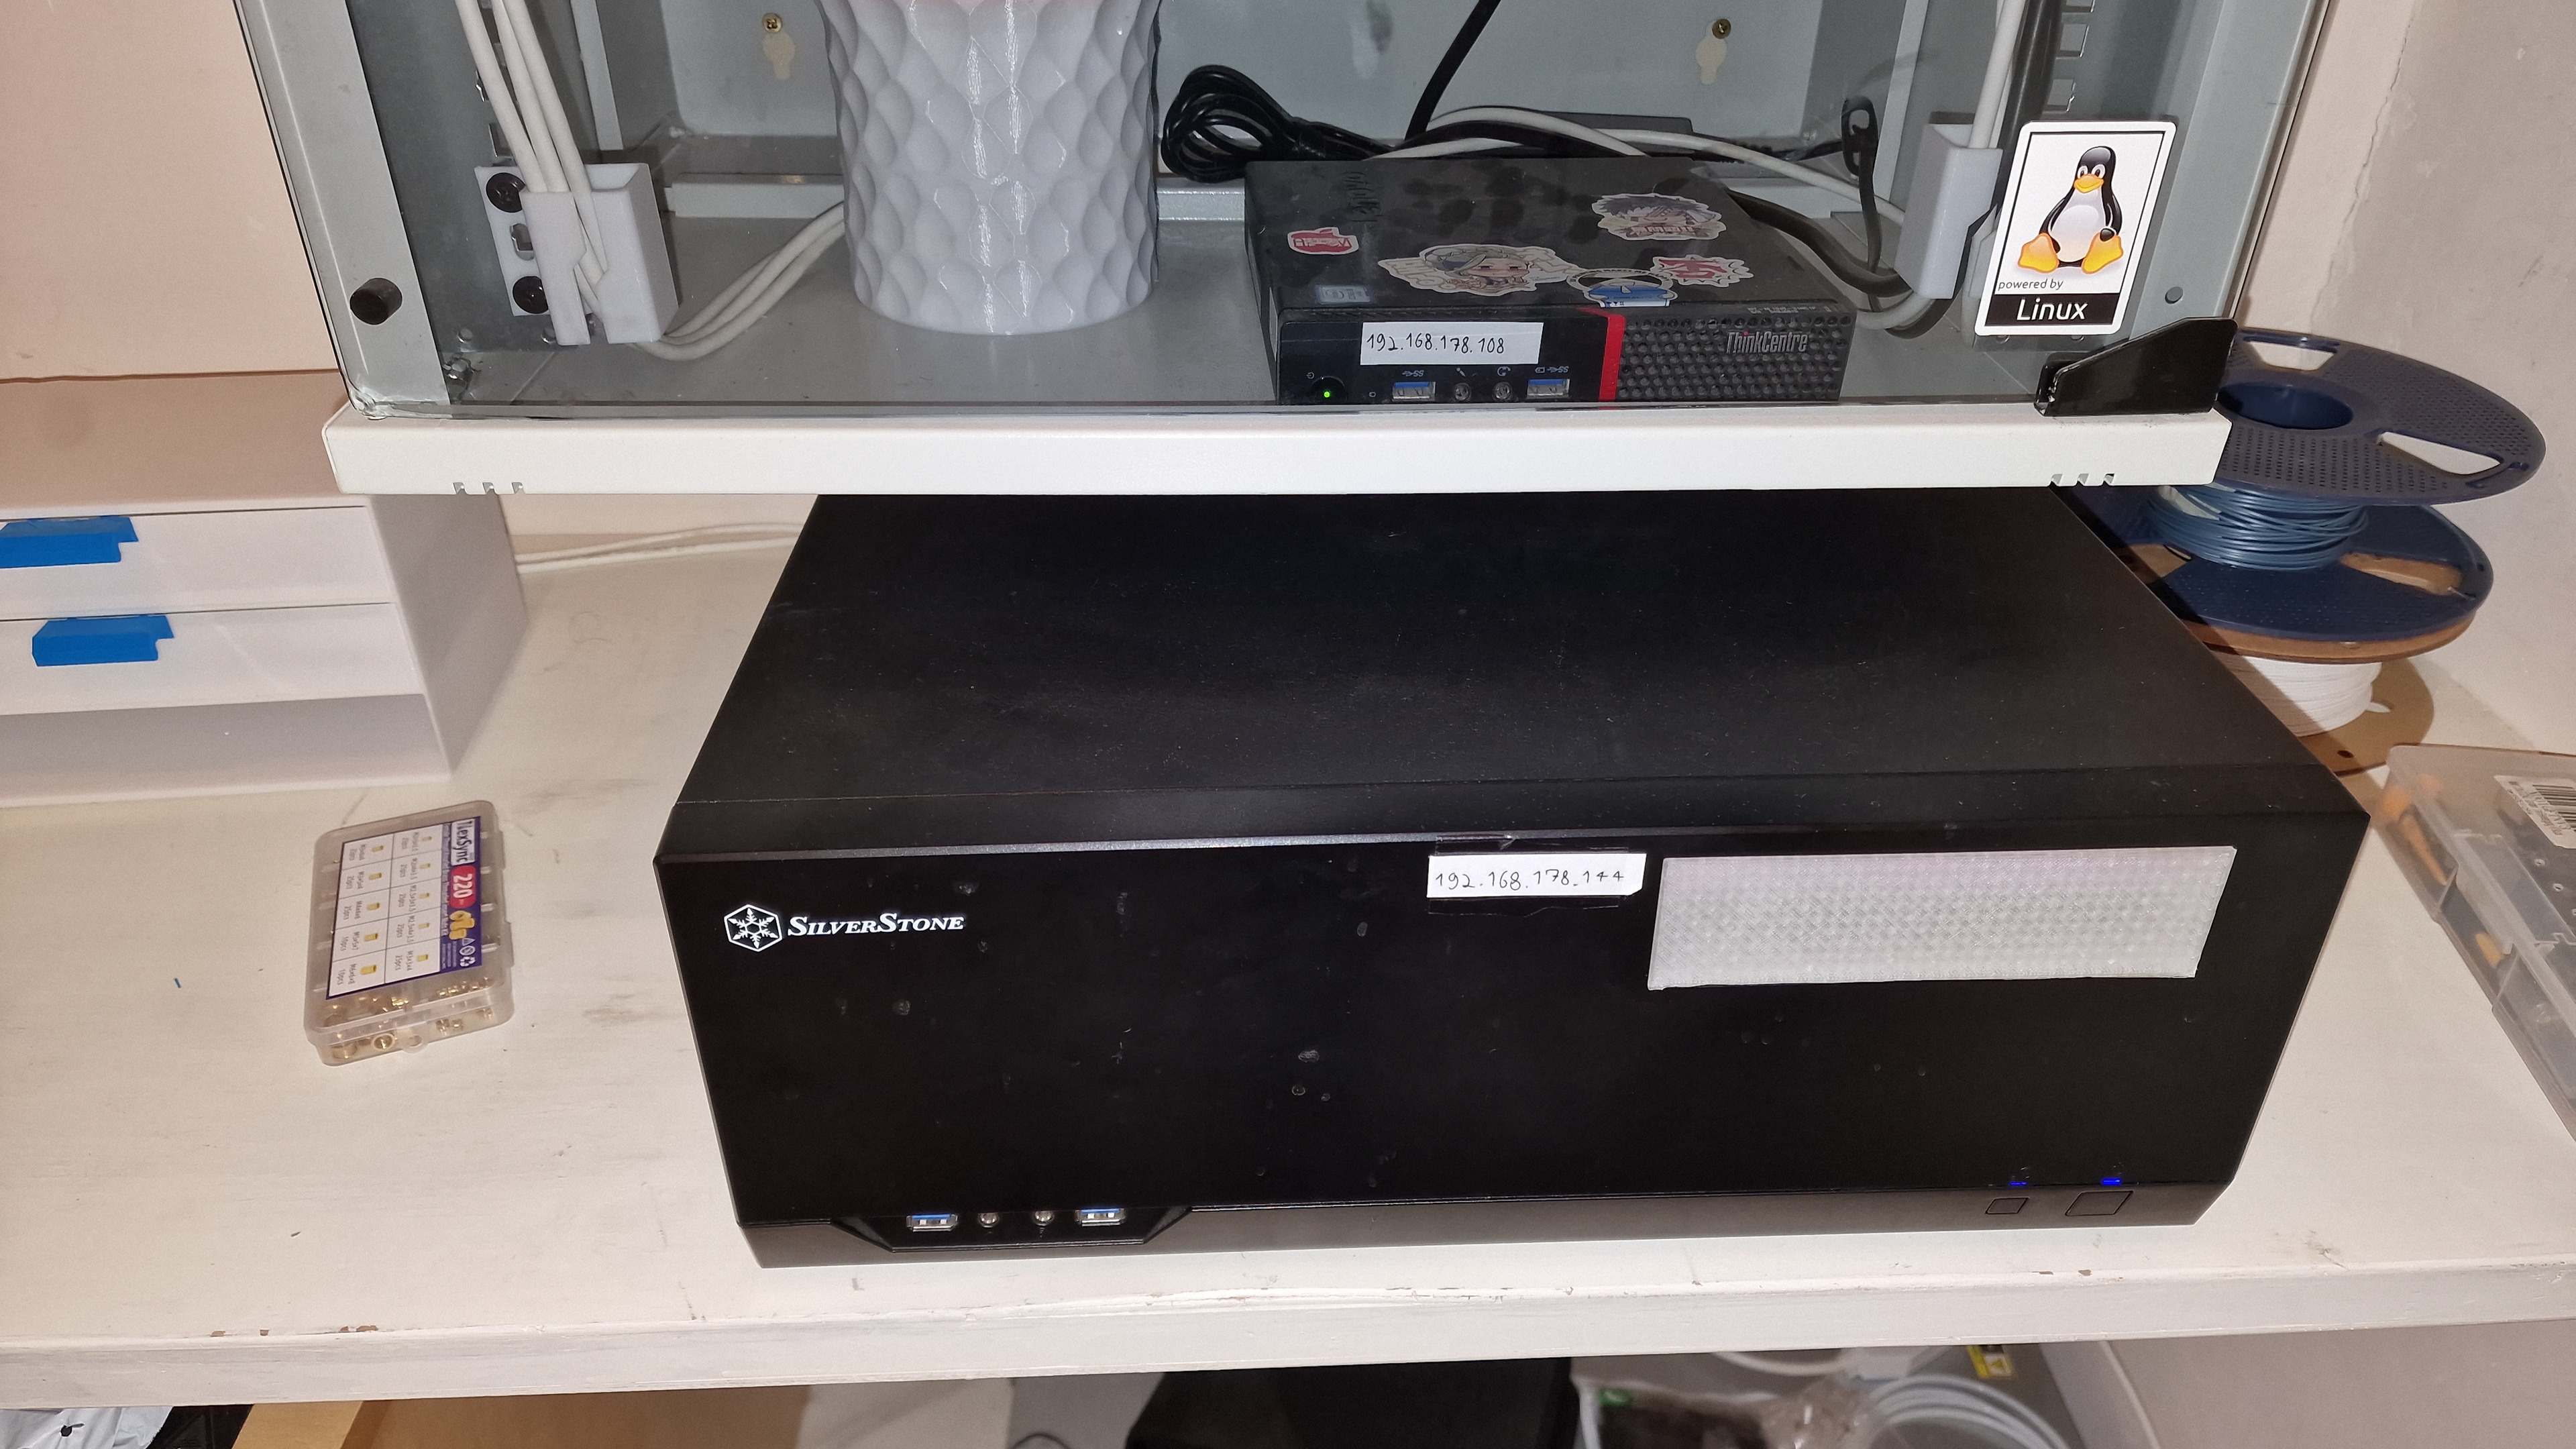
Quando ho aggiornato il PC da gaming, invece di vendere i vecchi componenti li ho rimessi in gioco: un Ryzen 7 3700X, 32 GB di DDR4 e una B450 Pro4 sono finiti in un nuovo server.
Per lo storage ho fatto le cose sul serio: due SSD da 256 GB in RAID 0 per il sistema operativo, e quattro HDD da 4 TB in RAID 5 gestito con mdadm per i dati. Questo server fa girare Plex e funziona da NAS per tutta la casa. Configurare il RAID 5 software mi ha insegnato parecchio: ho dovuto studiare mdadm, capire come funziona la parità distribuita e, soprattutto, imparare sulla mia pelle quanto contano i backup.
Il PC da gaming e la RTX 3090
Il mio setup principale è un PC da gaming con Ryzen 7 9800X3D, 32 GB di DDR5 e una RTX 3090. Nato per giocare, è diventato la mia workstation per machine learning e sviluppo.
I 24 GB di VRAM della 3090 sono perfetti per far girare modelli linguistici in locale: al momento uso soprattutto Qwen Coder e Gemma tramite Ollama. Uso questa macchina anche per Local RAG Example, dove sperimento con retrieval-augmented generation e database vettoriali: avere la GPU sempre disponibile permette di iterare in fretta.
Ubuntu ovunque
Su tutti i server gira Ubuntu. La scelta non è stata filosofica: è la distribuzione più diffusa, quindi per qualsiasi problema c'è già una guida o un thread che qualcuno ha risolto prima di te. Quando qualcosa si rompe alle due di notte, la popolarità conta più della purezza tecnica. E avendo la stessa distribuzione su tutte le macchine, riuso script e configurazioni senza adattare niente.
Rete: VPN, e niente più deploy automatici
Tutti i server si raggiungono attraverso una VPN, così li gestisco da qualsiasi posto mantenendo la sicurezza. Per un periodo avevo anche configurato SSH con un proxy perché le pipeline su GitHub Actions facessero il deploy direttamente sui server. Poi, per motivi di sicurezza, ho eliminato tutti i deploy automatici verso le mie macchine.
Monitoraggio: ovvero, la sua assenza
Lo ammetto: non ho un sistema di monitoraggio strutturato. Niente Grafana, niente Prometheus, niente alert automatici. Il mio approccio è molto più… empirico: se qualcosa si rompe, me ne accorgo quando qualcosa non va. È qualcosa che devo migliorare, e il monitoraggio proattivo è in cima alla lista delle prossime cose da fare.
Backup: incrociare le dita
Anche qui confesso: la mia strategia di backup è… ottimista. "Sperare che vada bene" non è esattamente quello che insegnano, ma finora è andata. I dati davvero critici sono duplicati sul cloud; per il resto mi affido al RAID 5 e alla fortuna. Me lo posso permettere perché quasi tutto quello che gira sui miei server è sperimentale o riproducibile: se domani il RAID 5 morisse, perderei file e media, ma non il codice, che è su GitHub, né le configurazioni critiche, che ho documentato. È un rischio calcolato, forse un po' troppo calcolato.


